SQL i bazy danych
Od pytania biznesowego do SQL z AI: jak nie dać się zaskoczyć
AI pisze zapytanie SQL w kilka sekund, a za wynik odpowiadasz Ty. Pokazuję pułapki złączeń, NULL-i i dat oraz prosty protokół sprawdzania zapytań.
Pytanie przychodzi na komunikatorze w czwartek po południu: „ile zarobiliśmy we wrześniu na zamówieniach z książkami?”. Wklejam je do czatu z AI i po kilku sekundach mam zapytanie SQL. Wygląda porządnie: ma aliasy, wcięcia, a nawet komentarz. Uruchamiam je, baza odpowiada bez jednego błędu, liczba pojawia się na ekranie. Jest o kilkanaście procent za wysoka i nic w niej tego nie zdradza.
Tak wygląda codzienność pracy z AI przy bazach danych. Model pisze SQL szybciej niż ktokolwiek z nas, a w prostych przypadkach pisze go naprawdę dobrze. Za to, co zapytanie policzy, odpowiada jednak osoba, która wyśle wynik dalej. W czwartym tygodniu kursu, w temacie „Od pytania biznesowego do SQL”, ćwiczymy właśnie to przejście: od pytania zadanego ludzkim językiem do zapytania, któremu można zaufać. W tym artykule opiszę, jak to robię, jakie pułapki widuję najczęściej i jak je wyłapać, zanim wynik trafi na slajd.
Dlaczego „zapytanie działa” to za mało
Baza danych ocenia zapytanie według bardzo skromnego kryterium. Sprawdza, czy składnia jest poprawna i czy tabele oraz kolumny istnieją. Jeśli tak, wykonuje polecenie i zwraca wynik. O Twoim biznesie wie dokładnie tyle, ile jest w schemacie, czyli zwykle niewiele. Zapytanie, które zsumuje wartość jednego zamówienia trzy razy, wykona z takim samym spokojem jak zapytanie poprawne.
Dlatego najgroźniejsze zapytanie to takie, które działa. Błąd składni jest uczciwy: widać go od razu, model go poprawia i po minucie jedziemy dalej. Zapytanie, które wykonuje się bez zarzutu i liczy coś trochę innego, przechodzi przez wszystkie automatyczne bramki i zatrzymuje się dopiero na człowieku, który zna liczby. Albo nie zatrzymuje się wcale i trafia do prezentacji dla zarządu.
Co mówią benchmarki
Skąd w ogóle wiadomo, jak dobrze modele piszą SQL? Badacze mierzą to na benchmarkach text-to-SQL, czyli zestawach pytań w języku naturalnym z bazami i wzorcowymi odpowiedziami. Jednym z najbardziej znanych jest BIRD. Według pracy, w której go opisano, zawiera 12 751 par pytanie i zapytanie oraz 95 baz o łącznym rozmiarze 33,4 GB z 37 dziedzin. Autorzy celowo dodali to, co znamy z życia: brudne dane i pytania, które wymagają wiedzy spoza samej bazy. W tamtej pracy najlepszy badany model, ChatGPT, osiągnął 40,08 procent poprawności wykonania, a ludzie 92,96 procent. Ranking na stronie projektu pokazuje dziś najlepsze wyniki powyżej 80 procent, więc postęp jest wyraźny.
Jeszcze ciekawszy jest Spider 2.0, zbudowany z zadań przypominających prawdziwe środowiska firmowe. Bazy często mają tam ponad tysiąc kolumn, a wzorcowe zapytania nierzadko przekraczają sto linii. W pracy opisującej benchmark autorzy zebrali 632 takie zadania i podali, że ich agent oparty na modelu o1-preview rozwiązał 21,3 procent z nich, podczas gdy na starszych zbiorach wynik wynosił 91,2 procent (Spider 1.0) i 73 procent (BIRD). Od tamtej pory wyspecjalizowane systemy w rankingu projektu bardzo podniosły wyniki.
Wyciągam z tego dwa wnioski. Pierwszy: modele szybko się poprawiają i przy dobrze opisanych danych potrafią naprawdę dużo. Drugi: każdy benchmark mierzy skuteczność na swoim zestawie baz i pytań. Twoja hurtownia ma kolumny nazwane przez kogoś, kto dawno zmienił pracę, statusy, których nikt nie spisał, i definicję przychodu, która zmieniła się w zeszłym roku. Wyniki z rankingu przenoszą się na nią co najwyżej częściowo. Liczba, która Cię naprawdę interesuje, to odsetek poprawnych zapytań na Twoich danych, a tę poznajesz dopiero przez weryfikację.
Jest w BIRD jeszcze jeden szczegół, który bardzo lubię. Do wielu pytań benchmark dołącza tak zwaną wiedzę zewnętrzną, czyli podpowiedź w rodzaju „kredyt może dostać konto typu właściciel”, z której model wyprowadza warunek na odpowiedniej kolumnie. W Twojej firmie nikt takich podpowiedzi modelowi nie dołącza. Chyba że zrobisz to Ty.
Schemat, relacje i słownik danych
Model piszący SQL widzi to, co mu pokażesz. Jeśli dasz mu samo pytanie, zgadnie nazwy tabel. Jeśli dasz mu schemat, zgadnie znaczenie kolumn. Jeśli dasz mu schemat i słownik danych, zgadywania zostaje niewiele. Dlatego w kursie pierwszym krokiem jest poznanie schematu, a zapytania przychodzą później.
Schemat i relacje
Minimum to definicje tabel, których dotyczy pytanie: nazwy kolumn, typy i klucze. W większości baz wyciągniesz je jednym poleceniem albo z widoków systemowych, a agent podłączony do bazy zrobi to sam. Do tego potrzebne są relacje: która kolumna wskazuje na którą tabelę i czy relacja jest jeden do jednego, czy jeden do wielu. Ta druga informacja decyduje o tym, czy złączenie pomnoży wiersze, więc do niej jeszcze wrócę.
Ziarnistość, czyli co oznacza jeden wiersz
Najważniejsze zdanie w opisie każdej tabeli zaczyna się od słów „jeden wiersz to…”. Jedno zamówienie? Jedna pozycja w zamówieniu? Jedna próba płatności? Stan magazynu na koniec dnia? Większość błędów, które widuję w zapytaniach pisanych przez AI (i przez ludzi, żeby była jasność), bierze się z pomylenia ziarnistości. Model widzi kolumnę z wartością w tabeli pozycji i w tabeli zamówień i nie wie, która jest sumą której.
Słownik danych
Słownik to miejsce na wszystko, czego nie widać w schemacie. Co oznaczają poszczególne wartości statusu. W jakiej jednostce zapisano kwoty: w złotych czy w groszach. W jakiej strefie czasowej są daty. Jak oznaczone są zamówienia testowe. Czy usunięte rekordy znikają z tabeli, czy dostają flagę. To dokładnie ta wiedza, którą BIRD podaje modelowi w podpowiedziach, a którą w firmie trzeba spisać samodzielnie.
Gdzie ją trzymać? W briefie, jeśli dotyczy jednej analizy, i w stałych plikach projektu, jeśli wraca przy każdej. Kajo opisał oba miejsca w artykułach o briefie zamiast prompta i o pamięci projektu w README, AGENTS.md i CLAUDE.md. Przy bazie danych dobrze sprawdza się osobny plik ze słownikiem, do którego plik instrukcji odsyła.
Osobną kategorią są definicje wskaźników. „Aktywny klient”, „przychód netto” albo „zamówienie zrealizowane” w każdej firmie znaczą coś trochę innego. O tym, jak je spisać i co zrobić, gdy dwa źródła się kłócą, piszę w artykule o definicjach KPI i źródłach prawdy.
Pięć pułapek, które widuję najczęściej
Poniższa lista jest krótka i dość nudna. Mimo to obejmuje większość błędów w zapytaniach, które sprawdzałam, zarówno tych od modelu, jak i tych od ludzi.
1. Złączenie, które mnoży wiersze
Wróćmy do pytania z początku: ile przychodu przyniosły we wrześniu zamówienia, w których była co najmniej jedna książka. Mamy tabelę zamowienia, w której jeden wiersz to jedno zamówienie z kolumną wartosc, oraz tabelę pozycje, w której jeden wiersz to jedna pozycja zamówienia z kolumną kategoria. Dane są przykładowe. Model proponuje coś takiego:
-- Wersja z modelu: wykonuje się bez błędu
SELECT SUM(z.wartosc) AS przychod
FROM zamowienia z
JOIN pozycje p ON p.zamowienie_id = z.id
WHERE p.kategoria = 'ksiazki'
  AND z.data_zamowienia >= '2026-09-01'
  AND z.data_zamowienia <  '2026-10-01';
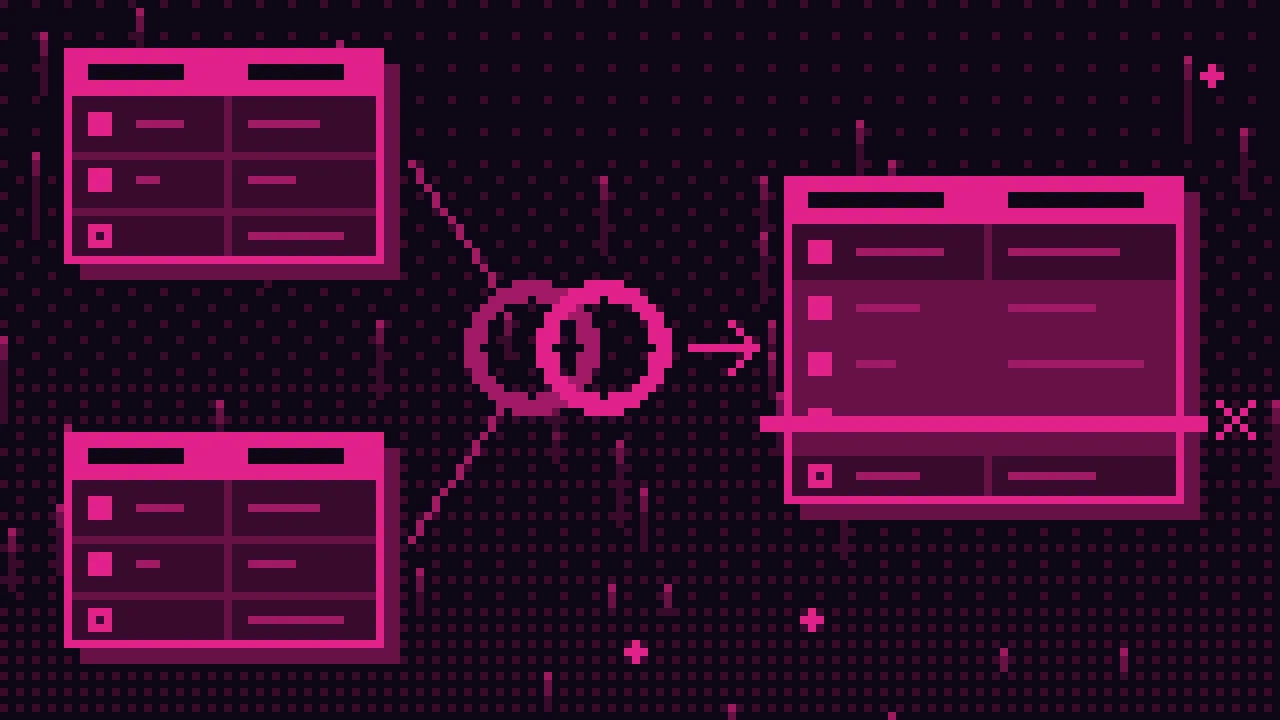
Zapytanie jest poprawne składniowo i wygląda rozsądnie. Kłopot zaczyna się przy zamówieniu, w którym są trzy książki. Złączenie zwraca dla niego trzy wiersze, a SUM dodaje jego wartość trzy razy. Wynik rośnie po cichu, tym bardziej, im częściej klienci kupują kilka książek naraz.
Najprostszy test to porównanie liczby wierszy po złączeniu z liczbą unikalnych zamówień:
SELECT COUNT(*)             AS wiersze,
       COUNT(DISTINCT z.id) AS zamowienia
FROM zamowienia z
JOIN pozycje p ON p.zamowienie_id = z.id
WHERE p.kategoria = 'ksiazki';
Jeśli wiersze jest większe od zamowienia, złączenie mnoży rekordy i każda suma po kolumnie z tabeli zamówień będzie zawyżona. Poprawiona wersja sprawdza, czy w zamówieniu jest książka, i przy tym nie dokłada wierszy:
SELECT SUM(z.wartosc) AS przychod
FROM zamowienia z
WHERE z.data_zamowienia >= '2026-09-01'
  AND z.data_zamowienia <  '2026-10-01'
  AND EXISTS (
    SELECT 1
    FROM pozycje p
    WHERE p.zamowienie_id = z.id
      AND p.kategoria = 'ksiazki'
  );
Ta sama pułapka czai się przy każdej relacji jeden do wielu: zamówienia i płatności (bo za jedno zamówienie można zapłacić w kilku transakcjach), klienci i adresy, produkty i historia cen. Model zna wzorzec z EXISTS doskonale. Potrzebuje jednak informacji, że relacja jest jeden do wielu, i stąd mój nacisk na ziarnistość w opisie tabel.
2. Filtr w złym miejscu
Prosisz o listę wszystkich klientów z liczbą zamówień we wrześniu, łącznie z tymi, którzy nic nie kupili. Model pisze LEFT JOIN do tabeli zamówień i dorzuca warunek na datę zamówienia w WHERE. Klienci bez zamówień mają w kolumnach zamówień wartości NULL, więc warunek na dacie ich odrzuca, a złączenie zewnętrzne zachowuje się jak zwykłe. Klienci z zerem znikają z listy, a razem z nimi informacja o tym, ilu ich jest. Warunek na datę powinien trafić do klauzuli ON.
Podobnie bywa z warunkami po agregacji. Filtr „klienci z co najmniej trzema zamówieniami” należy do HAVING, a filtr na pojedyncze zamówienia do WHERE. Pomylenie miejsc daje wynik, który wygląda wiarygodnie i odpowiada na inne pytanie niż zadane.
3. NULL, który zjada wiersze
Warunek WHERE status <> 'anulowane' czyta się jak „wszystko poza anulowanymi”. W SQL porównanie z NULL daje jednak wynik nieznany, więc wiersze bez statusu też odpadną. Podobnych niespodzianek jest więcej. COUNT(kolumna) liczy wyłącznie wartości wypełnione, a AVG pomija braki, co bywa właściwe albo zupełnie błędne, zależnie od tego, co brak oznacza. Klasyk z wyższej półki to NOT IN z podzapytaniem: wystarczy jeden NULL w podzapytaniu, żeby całe zapytanie zwróciło pusty wynik.
Dlatego w słowniku danych warto zapisać, co oznacza brak w kluczowych kolumnach. Status nieznany? Zamówienie w trakcie realizacji? Błąd importu? Model, który to wie, napisze warunek świadomie.
4. Daty i strefy czasowe
Systemy często zapisują czas w UTC, a biznes liczy dni po polsku. Zamówienie złożone 1 października o 0:30 czasu polskiego ma w UTC datę 30 września, godzinę 22:30, więc trafi do wrześniowej sprzedaży. W skali miesiąca to zwykle drobiazg. W skali jednego dnia z dużym ruchem wieczorem potrafi wyraźnie zmienić wynik. W PostgreSQL przeliczenie na polski czas zapewnia AT TIME ZONE 'Europe/Warsaw', a informacja o strefie zapisu należy do słownika danych.
Druga klasyczna wpadka to BETWEEN '2026-09-01' AND '2026-09-30' na kolumnie, która przechowuje także godzinę. Górna granica oznacza wtedy 30 września, godzinę 0:00, więc prawie cały ostatni dzień miesiąca wypada z zakresu. Bezpieczniej używać przedziału domkniętego z jednej strony, tak jak w przykładach powyżej: od pierwszego dnia miesiąca włącznie do pierwszego dnia następnego miesiąca wyłącznie.
5. Definicja wskaźnika wymyślona przez model
Ostatnia pułapka jest najmniej techniczna. Poproszony o „aktywnych klientów” model wybierze definicję, która wydaje mu się najbardziej typowa: zamówienie w ostatnich trzydziestu dniach, logowanie na konto albo cokolwiek z tabeli, która ma w nazwie słowo „activity”. Zapytanie będzie bezbłędne technicznie i policzy pojęcie, którego nikt w firmie nie używa. Pomaga definicja w słowniku i prośba, by model przed napisaniem zapytania powtórzył ją własnymi słowami. Szerzej opisywałam to w artykule o sprawdzaniu wyników AI, przy kontroli definicji.
Bezpieczny dostęp: tylko odczyt, osobny użytkownik, limity i log
Wszystko powyżej dotyczy poprawności. Zostaje bezpieczeństwo, któremu w kursie poświęcamy drugi temat czwartego tygodnia: bezpieczne podłączenie bazy danych. Gdy agent ma połączenie z bazą, sam uruchamia zapytania, poprawia je i uruchamia ponownie. To ogromna wygoda i spora odpowiedzialność, bo model, który potrafi napisać SELECT, równie sprawnie napisze DELETE. Różnicę między czatem a agentem, który sam wykonuje kolejne kroki, Kajo opisał w artykule o tym, jak wybrać między modelem, czatem i agentem.
Moje zasady są proste:
- Osobny użytkownik dla AI. Agent nigdy nie korzysta z mojego konta, a już na pewno z konta administratora. Dzięki temu w logu widać, co zrobił on, a co ja.
- Tylko odczyt, wymuszony uprawnieniami. Użytkownik dostaje prawo
SELECTna wybranym schemacie i nic więcej. Przykład dla PostgreSQL znajdziesz niżej. - Sekrety w pliku
.env. Dane logowania nie trafiają do briefu, do plików instrukcji ani do repozytorium. Trzymam je w pliku.env, który jest wpisany do.gitignore, a agent odczytuje je jako zmienne środowiskowe. - Kopia albo replika, gdy to możliwe. Analiza rzadko potrzebuje danych sprzed sekundy. Replika do odczytu albo nocna kopia oddzielają eksperymenty od systemu, na którym pracuje firma.
- Bez danych osobowych. Schemat udostępniony AI zawiera tabele potrzebne do analizy. Imiona, adresy i telefony zostają poza zasięgiem uprawnień albo trafiają do widoku po pseudonimizacji.
- Limity. Limit czasu pojedynczego zapytania chroni bazę przed złączeniem, które przypadkiem próbuje zestawić każdy wiersz z każdym. W hurtowniach rozliczanych za ilość przetworzonych danych warto dodatkowo ustawić limit kosztu zapytania.
- Log. Każde zapytanie wykonane przez użytkownika AI zostaje zapisane. Log odpowiada na pytanie, które prędzej czy później pada na każdym spotkaniu: skąd ta liczba?
W PostgreSQL taki użytkownik może wyglądać tak (hasło ustawia administrator i nie pojawia się w żadnym pliku projektu):
-- Osobny użytkownik dla AI: odczyt wybranego schematu
CREATE ROLE ai_odczyt LOGIN;
GRANT CONNECT ON DATABASE sklep TO ai_odczyt;
GRANT USAGE ON SCHEMA raporty TO ai_odczyt;
GRANT SELECT ON ALL TABLES IN SCHEMA raporty TO ai_odczyt;
ALTER DEFAULT PRIVILEGES IN SCHEMA raporty
  GRANT SELECT ON TABLES TO ai_odczyt;

-- Dodatkowe pasy bezpieczeństwa
ALTER ROLE ai_odczyt SET default_transaction_read_only = on;
ALTER ROLE ai_odczyt SET statement_timeout = '30s';
ALTER ROLE ai_odczyt SET log_statement = 'all';
Polecenie GRANT daje prawo odczytu tabel w schemacie raporty, a ALTER DEFAULT PRIVILEGES rozciąga je na tabele, które rola wykonująca polecenie utworzy tam później. Parametr default_transaction_read_only ze stron o ustawieniach sesji sprawia, że każda nowa transakcja startuje w trybie tylko do odczytu, a statement_timeout przerywa polecenia trwające dłużej niż zadany czas. Traktuję je jako pasy bezpieczeństwa: użytkownik może zmienić tryb transakcji we własnej sesji, więc prawdziwą barierą pozostają uprawnienia. Parametr log_statement z wartością all zapisuje w logu serwera każde polecenie tej roli. Ustawić go może wyłącznie administrator. I dobrze, bo to on powinien decydować o tym, co się loguje.
Jak czytam zapytanie od AI
Zapytanie SQL pisze się w innej kolejności, niż baza je wykonuje. Zaczyna się od SELECT, a logicznie najpierw liczą się FROM i złączenia, potem WHERE, GROUP BY, HAVING, dopiero na końcu SELECT, sortowanie i limit. Czytam więc w kolejności wykonania i przy każdym kroku zadaję sobie pytanie: co teraz oznacza jeden wiersz?
Pomaga w tym kilka nawyków:
- Najpierw wyjaśnienie, potem kod. Proszę model, żeby opisał każdy krok zapytania jednym zdaniem i podał ziarnistość wyniku po każdym kroku. Jeśli zapytanie ma kilka bloków
WITH, każdy dostaje własny opis. Rozbieżność między opisem a kodem to pierwszy trop. - Założenia na głos. Proszę o listę założeń i miejsc, w których model zgadywał: którą kolumnę uznał za datę sprzedaży, co zrobił z brakami, czy wykluczył zamówienia testowe. Zgadywanie wypowiedziane na głos da się sprawdzić w minutę.
- Liczba wierszy po każdym złączeniu. Ten sam test co w pułapce pierwszej, wykonany dla każdego
JOIN. - Mała próbka o znanym wyniku. Biorę jedno zamówienie, jednego klienta albo jeden dzień i liczę wynik niezależnie: w arkuszu, prostszym zapytaniem albo na kartce. Jeszcze lepiej działa mała tabela testowa, w której celowo umieszczam przypadki skrajne: zamówienie z trzema książkami, wiersz bez statusu, zamówienie z 1 października o 0:30. Znam wynik z góry, więc od razu widzę, który przypadek zapytanie obsłużyło źle.
- Porównanie z niezależnym źródłem. Suma z zapytania powinna zgadzać się z raportem finansowym albo z innym uznanym źródłem w ustalonej tolerancji.
Protokół w pięciu krokach
Wszystko to składa się w powtarzalny schemat, którego uczymy w kursie. Ma pięć kroków: pytanie, schemat, zapytanie, wyjaśnienie, weryfikacja.
- Pytanie. Zamieniam pytanie biznesowe na precyzyjne. „Ile zarobiliśmy we wrześniu” staje się „sumą wartości netto opłaconych zamówień złożonych od 1 do 30 września czasu polskiego, bez zamówień testowych, w złotych”. Jeśli nie umiem tego zrobić, wracam z pytaniem do osoby, która zleciła analizę. To najtańszy moment na wyjaśnienie nieporozumień.
- Schemat. Model dostaje albo sam pobiera definicje właściwych tabel, relacje i słownik danych. Proszę go, żeby przed napisaniem zapytania wypisał brakujące informacje.
- Zapytanie. Proszę o zapytanie podzielone na nazwane kroki, z których każdy robi jedną rzecz. Czytelność jest tu ważniejsza od zwięzłości, bo zapytanie będę czytać ja.
- Wyjaśnienie. Model opisuje kroki, ziarnistość i założenia. Porównuję opis z kodem.
- Weryfikacja. Liczba wierszy po złączeniach, próbka o znanym wyniku, porównanie z niezależnym źródłem. Sprawdzone zapytanie zapisuję razem z opisem w repozytorium projektu, żeby następnym razem zaczynać od wersji poprawionej.
Protokół wygląda na dłuższy niż prośba „napisz mi zapytanie”. W praktyce kroki od drugiego do czwartego wykonuje głównie model, a ja najwięcej czasu poświęcam pierwszemu i ostatniemu. Tak też powinno być, bo to są kroki, w których potrzebna jest wiedza o firmie.
Co zostaje po stronie analityka
Z czasem zauważyłam, że pisania składni mam coraz mniej. Zostało wszystko, co dzieje się przed zapytaniem i po nim. Zamiana luźnego pytania na precyzyjne. Wiedza o danych: ziarnistość tabel, dziwactwa statusów, strefy czasowe, historia zmian w definicjach. Decyzja o tym, do czego AI ma dostęp. Ocena wyniku i odpowiedzialność za liczbę, która trafia do decyzji.
Znajomość SQL nadal się przydaje, zmienia się tylko jej rola: z pisania przechodzi w czytanie. Kto rozumie JOIN, GROUP BY i zachowanie NULL, wyłapie błąd w kilka sekund. Kto tego nie rozumie, musi zapytaniu ufać, a ufanie zapytaniu, którego się nie rozumie, jest w analizie danych dość kosztownym hobby.
Jeśli po tym artykule zrobisz tylko jedną rzecz, niech to będzie ta: przy następnym zapytaniu od AI porównaj liczbę wierszy przed złączeniem i po nim. Kosztuje to jedno dodatkowe zapytanie. Raz na jakiś czas oszczędzi Ci spotkania, na którym ktoś z finansów zapyta, dlaczego Twoja liczba różni się od ich raportu.
Najważniejsze pytania i odpowiedzi
Czy dać AI dostęp do bazy produkcyjnej?
Najbezpieczniej zacząć od kopii albo repliki z danymi do analizy. Jeśli połączenie z produkcją jest konieczne, to przez osobnego użytkownika z prawem odczytu wybranych schematów, z limitem czasu zapytań i z logowaniem wszystkiego, co wykonał. Dane logowania trzymam w pliku .env poza repozytorium, a tabele z danymi osobowymi wyłączam z uprawnień.
Jak sprawdzić zapytanie SQL wygenerowane przez AI?
Proszę model o wyjaśnienie każdego kroku, a potem czytam zapytanie w kolejności wykonania: tabele i złączenia, filtry, grupowanie. Po każdym złączeniu porównuję liczbę wierszy z liczbą unikalnych kluczy, uruchamiam zapytanie na małej próbce o znanym wyniku i porównuję sumę z niezależnym raportem.
Czy trzeba znać SQL, żeby korzystać z AI do zapytań?
Pisanie można w dużej mierze oddać modelowi. Czytanie zostaje po Twojej stronie: trzeba rozumieć SELECT, JOIN, WHERE, GROUP BY i zachowanie wartości NULL. To kilka godzin nauki, które zwracają się przy pierwszym zapytaniu, które wykonuje się bez błędu i liczy coś innego, niż miało.
Źródła
- Lei i in.: Spider 2.0. Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows
- Spider 2.0: strona projektu i ranking
- Li i in.: Can LLM Already Serve as A Database Interface? A Big Bench for Large-Scale Database Grounded Text-to-SQLs (BIRD)
- BIRD: strona benchmarku i ranking
- PostgreSQL: polecenie GRANT
- PostgreSQL: parametry sesji (default_transaction_read_only, statement_timeout)
- PostgreSQL: logowanie zapytań (log_statement)
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
Chcesz przećwiczyć to na własnych danych?
Analiza z AI to 6 tygodni praktyki z Kajo i Kasią. Start 11 stycznia 2027.